VoxFocus

SENSE / KLARE SPRACHE FÜR MASCHINEN & ROBOTER

Besseres Audio.
Besserer Input für Sprach-KI.

Die akustische Schicht zwischen einer lauten Fabrik und Ihrem bestehenden Sprachsystem. Sie verarbeitet Sprache auf dem Gerät, in Echtzeit.

Industrielle Sprachschnittstellen beginnen mit einem Mikrofonsignal, das Sprache, Maschinen und Nachhall enthält. SENSE wird entwickelt, um die relevante Sprache herauszutrennen, bevor dieses Signal die Spracherkennung und die Befehlsinterpretation erreicht.

Maschinenschnittstellen

Sprache für sprachgesteuerte HMI und Bedienoberflächen aufbereiten.

Robotik

Aufbereitetes Audio für bestehende Sprachinteraktions-Pipelines von Robotern liefern.

OEM-Integration

Eine Modul- oder Softwareintegration rund um das Produkt und die Schnittstellen des Partners festlegen.
Ihre Integration besprechen
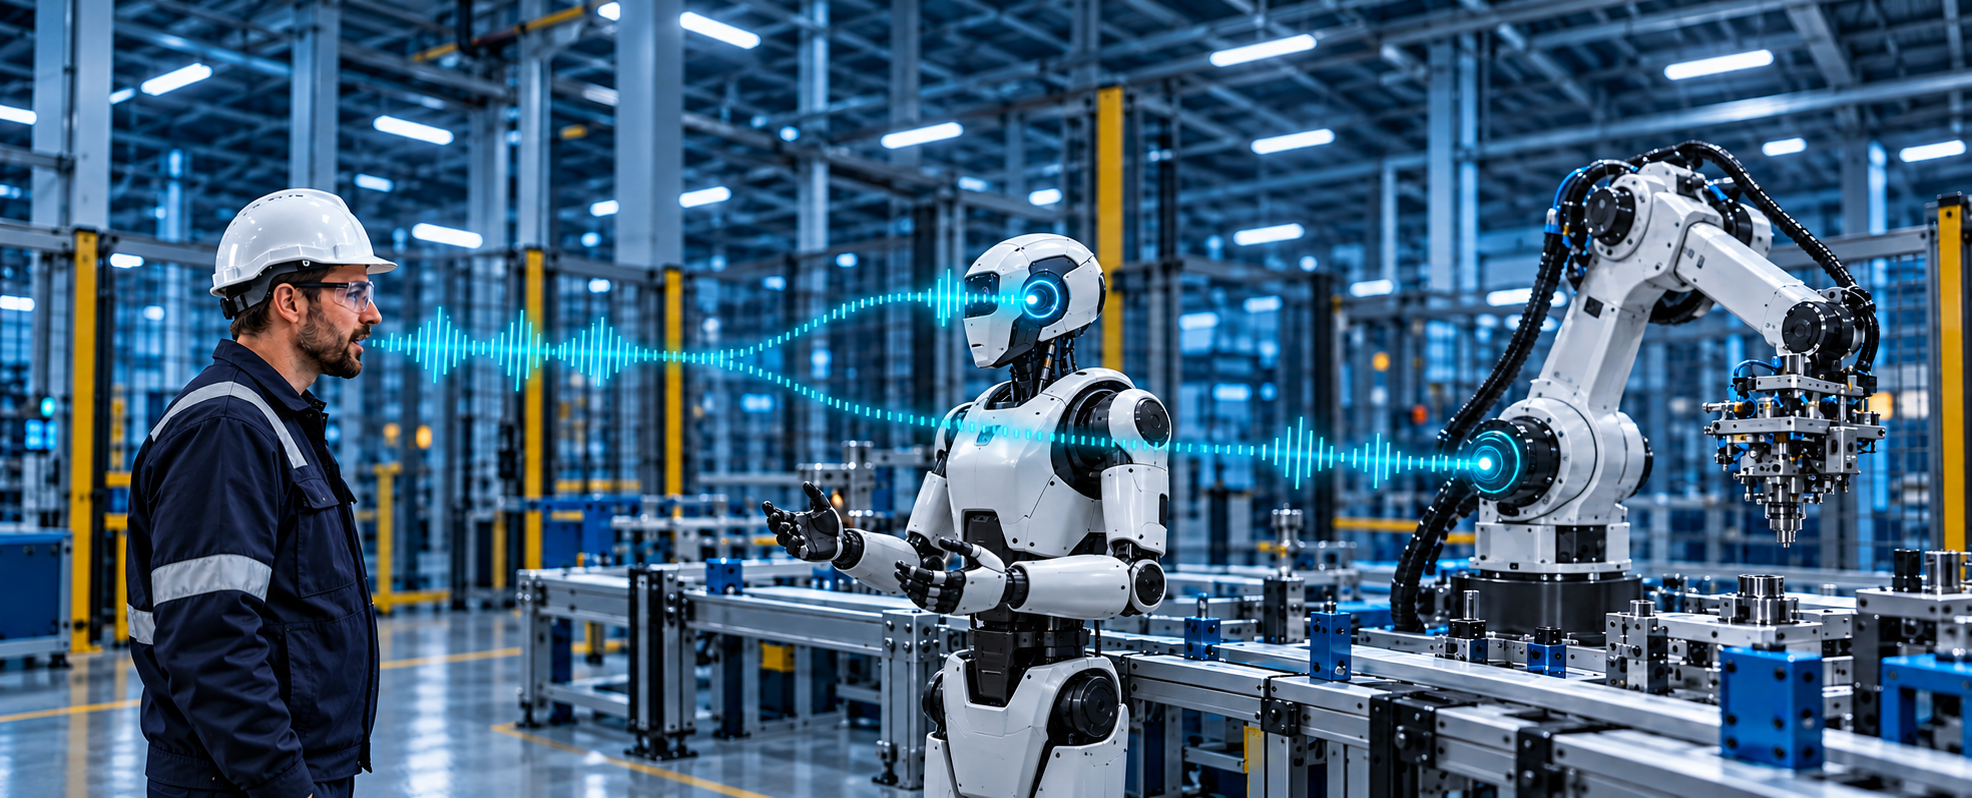
SENSE-Konzept: Ein Werker interagiert mit Industriemaschinen und einem Roboter
MENSCHLICHE STIMME → INDUSTRIELLE SPRACHSYSTEME Anwendungskonzept · Schnittstellen werden mit Designpartnern festgelegt
Gemischtes Audio → SENSE-Trennung → ASR / Intent-Verarbeitung

Maschinenaktionen, Bestätigung und Sicherheitslogik bleiben im nachgelagerten System. Pilotprojekte messen Erkennungsqualität, Fehlauslösungen und Latenz.

SPEECH-TO-TEXT IM LÄRM

Selbst führendes Speech-to-Text
hört Wörter, die niemand gesagt hat.

In lauten professionellen Umgebungen überhört Speech-to-Text nicht nur Wörter und Befehle. Es halluziniert neue. Jedes halluzinierte Wort zählt als weiterer Fehler, deshalb kann die Fehlerrate über 1000 % steigen – und Ihr System hört Befehle, die niemand gegeben hat. SENSE stoppt das an der Quelle: Unsere KI auf dem Gerät trennt Sprache in Echtzeit vom Lärm, bevor sie Speech-to-Text erreicht.

ECHTER TESTCLIP · OPENAI WHISPER, UNVERÄNDERT · FLUGHAFENLÄRM · 20 GESPROCHENE WÖRTER

GESPROCHEN„And those other gods were confined and adored alone in some peculiar places. Aesculapius and his temple and altars everywhere.“

OHNE VOXFOCUS Speech-to-Text mit dem unbearbeiteten Mikrofonsignal
MIT VOXFOCUS SENSE Dasselbe Speech-to-Text, nach der KI-Trennung auf dem Gerät

Beispiel: Ohne VoxFocus machte das Speech-to-Text-System aus 20 gesprochenen Wörtern 334 und wiederholte „open the door“ 109-mal, eine Wortfehlerrate von 1650 Prozent. Mit VoxFocus Sense transkribierte es den Satz korrekt, bis auf einen Namen in einer anderen Schreibweise, eine Wortfehlerrate von 5 Prozent.

Ausgewähltes Beispiel aus unserem simulierten Testdatensatz: ein LibriSpeech-Sprecher, der nicht im Training vorkam, gemischt mit aufgezeichnetem Flughafenlärm bei −5 dB SNR, aufgenommen mit dem SENSE-Mikrofonarray. Ohne VoxFocus hört Speech-to-Text das unbearbeitete Mikrofonsignal. Beide Aufnahmen werden gleich laut abgespielt. Speech-to-Text: OpenAI Whisper large-v3-turbo, unverändert. Wortfehlerrate = falsche + fehlende + erfundene Wörter, geteilt durch die 20 gesprochenen Wörter. Der einzige verbleibende Unterschied mit VoxFocus ist der Name „Asclepius“, die alternative Schreibweise von „Aesculapius“. Die Ergebnisse variieren je nach Clip.